Die These
Databricks wird als ETL-Tool unterschätzt, weil viele Unternehmen noch immer in alten ETL-Kategorien denken: grafische Pipelines, Konnektoren, Copy-Jobs, ein bisschen Transformation — fertig. Databricks dagegen sieht auf den ersten Blick eher aus wie eine Spark-Plattform, ein Lakehouse, ein Notebook-Spielplatz für Data Engineers oder eine AI-Plattform. Und genau deshalb wird es im ETL-Kontext oft zu spät ernst genommen.
Das ist ein bisschen so, als würde man einen Schweizer Taschenmesser-Hersteller fragen, ob er auch Flaschenöffner im Sortiment hat. Ja, hat er. Aber wenn man nur den Flaschenöffner betrachtet, übersieht man Messer, Schere, Schraubendreher, Pinzette, Säge und vermutlich auch das kleine Ding, von dem niemand genau weiß, wofür es da ist, das aber im entscheidenden Moment überraschend nützlich wird.
Databricks ist nicht das einfachste ETL-Tool. Es ist auch nicht immer das billigste, nicht immer das bequemste und ganz sicher nicht das Tool, das man „mal eben“ ohne Engineering-Verständnis produktiv einführt. Aber wenn ETL nicht nur als Datenverschiebung verstanden wird, sondern als skalierbares Fundament für Analytics, Data Products, Machine Learning und GenAI, dann ist Databricks eines der interessantesten Werkzeuge im Cloud-Computing-Umfeld.
Warum wir ETL neu denken müssen
Klassisches ETL war lange Zeit klar umrissen: Daten werden aus Quellsystemen extrahiert, transformiert und anschließend in ein Zielsystem geladen. Häufig war dieses Ziel ein Data Warehouse. Die Werkzeuge dafür waren oft visuell, stark workflow-orientiert und darauf ausgelegt, Daten von A nach B zu transportieren. Das war und ist für viele Szenarien immer noch absolut sinnvoll.
Aber moderne Datenplattformen funktionieren eben anders. Heute sprechen wir nicht mehr nur über nächtliche Batchverarbeitungen, sondern über Near-Real-Time-Streaming, Change Data Capture, Data Quality, Observability, Lineage, Governance, offene Dateiformate, Kostenoptimierung und AI-Readiness. Google beschreibt Dataflow beispielsweise als vollständig verwalteten Dienst für einheitliche Batch- und Streaming-Verarbeitung mit Apache Beam, Autoscaling und genau-einmal-Verarbeitung.
Auch AWS Glue positioniert sich nicht nur als ETL-Werkzeug, sondern als serverloser Data-Integration-Service mit Katalog, visueller Pipeline-Erstellung, Spark-basierter Verarbeitung und Integration in Analytics-Ökosysteme.
Das zeigt: ETL ist heute nicht mehr nur ein einzelner Prozessschritt. ETL ist ein Architekturthema.
Und genau hier wird Databricks spannend.
Databricks positioniert Lakeflow als einheitliche Data-Engineering-Lösung für Ingestion, Transformation und Orchestrierung. Dazu gehören Lakeflow Connect für die Datenaufnahme, Lakeflow Jobs für die Orchestrierung, Spark Declarative Pipelines für Batch- und Streaming-ETL sowie Unity Catalog für Governance und Lineage. Das klingt nicht nach einem kleinen ETL-Helferlein. Das klingt nach Plattform.
Der blinde Fleck: Databricks sieht nicht aus wie ein ETL-Tool
Viele Entscheider und Architekten haben bei ETL noch immer ein bestimmtes Bild im Kopf: eine Oberfläche mit Boxen und Pfeilen, links Quellsysteme, rechts Zielsysteme, dazwischen Transformationen. Wenn es besonders enterprisemäßig aussieht, gibt es noch ein paar Scheduler, Monitoring-Kacheln und Fehlermeldungen, die nur mit Kaffee und innerer Ruhe interpretierbar sind.
Databricks kommt anders daher. Notebooks. Code. Spark. Delta Lake. Cluster. Jobs. SQL Warehouses. Unity Catalog. MLflow. Feature Engineering. AI. Das wirkt für klassische ETL-Entwickler zunächst weniger wie „Datenintegration“ und mehr wie „Data Engineering für Fortgeschrittene“.
Doch das ist nicht Schwäche, sondern Stärke.
Databricks ist besonders dann stark, wenn Transformationen nicht trivial sind: große Datenmengen, komplexe Joins, inkrementelle Verarbeitung, Streaming-Daten, unstrukturierte Daten, ML-nahe Aufbereitung oder mehrstufige Datenmodelle im Bronze/Silver/Gold-Stil. Lakeflow Spark Declarative Pipelines unterstützen beispielsweise ETL-Szenarien mit Auto Loader, Datenqualitätsprüfungen, Deduplizierung, Materialized Views und Automatisierung über Databricks Jobs.
Der Punkt ist: Databricks ist nicht unterschätzt, weil es zu wenig ETL kann. Es wird unterschätzt, weil es ETL anders denkt.
Databricks als ETL-Motor: Wo die Plattform glänzt
Die erste große Stärke ist die Skalierung. Databricks basiert auf Apache Spark und ist damit für verteilte Verarbeitung großer Datenmengen ausgelegt. Das unterscheidet es von vielen Werkzeugen, die zwar gut orchestrieren oder kopieren können, aber bei wirklich komplexen Transformationen entweder an technische Grenzen stoßen oder schnell teuer werden. Hier sticht vor allem hervor, dass die zur Ausführung benötigten Cluster frei konfigurierbar sind. So lassen sich Prozesse zielgenau einrichten und an die notwendigen Gegebenheiten anpassen.
Natürlich sind auch AWS Glue und Google Dataflow skalierbare Cloud-Dienste. AWS Glue nutzt ebenfalls Apache Spark für serverlose ETL-Workloads und integriert sich eng in AWS-Services wie S3, Athena und Redshift. Google Dataflow wiederum basiert auf Apache Beam und ist besonders stark bei portablen Batch- und Streaming-Pipelines.
Databricks unterscheidet sich jedoch dadurch, dass es nicht nur eine Processing Engine bereitstellt, sondern eine umfassende Lakehouse-Plattform: Datenaufnahme, Transformation, Querying, Governance, Orchestrierung, Notebooks, SQL, Machine Learning und AI-Anwendungen liegen näher beieinander. Databricks beschreibt Lakeflow explizit als End-to-End-Lösung für zuverlässige Data Pipelines mit einheitlichem Tooling, effizienter Verarbeitung, Governance und Lineage.
Das macht Databricks besonders attraktiv für Unternehmen, die nicht nur „ETL-Jobs“ bauen wollen, sondern eine strategische Datenplattform.
Batch und Streaming: Bitte nicht zwei Welten bauen
Ein häufiges Architekturproblem in Unternehmen ist die künstliche Trennung zwischen Batch- und Streaming-Verarbeitung. Für Batch gibt es ein Tool. Für Streaming ein anderes. Für Orchestrierung ein drittes. Für Monitoring ein viertes. Für Governance ein fünftes. Am Ende hat man keine Datenplattform, sondern eine digitale Werkzeugkiste, die beim Öffnen verdächtig klappert.
Databricks verfolgt einen integrierteren Ansatz. Lakeflow Spark Declarative Pipelines können laut Dokumentation Batch- und Streaming-ETL vereinfachen und unter anderem Ingestion, Transformation, CDC-nahe Muster, Datenqualität und Governance unterstützen. Lakeflow Connect wiederum bietet Konnektoren und flexible Service-Modelle für Datenaufnahme aus Enterprise-Anwendungen, Datenbanken, Cloud Storage und Message-Systemen.
Das ist architektonisch relevant. Viele moderne Use Cases, etwa Fraud Detection, IoT, Digital Twins, Customer 360, Echtzeit-Inventar oder RAG-Anwendungen, funktionieren nicht sauber, wenn jede Datenbewegung als nächtlicher Batch gedacht wird.
Databricks nennt selbst Use Cases wie Customer 360, Portfolio Management, Consumer Analytics, Digital Twins und RAG-Chatbots im Kontext von Lakeflow Connect.
Kurz gesagt: Wer heute eine Datenplattform baut, sollte nicht fragen: „Welches ETL-Tool kopiert meine Daten?“ Sondern: „Wie verarbeite ich Daten zuverlässig, nachvollziehbar, skalierbar und wiederverwendbar, egal ob Batch oder Streaming?“
Vergleich mit Azure Data Factory: Dirigent gegen Transformationsmotor
Azure Data Factory ist ein sehr starkes Werkzeug für Datenintegration, insbesondere im Azure-Ökosystem. Microsoft beschreibt ADF als vollständig verwalteten, serverlosen Data-Integration-Service mit visueller Erstellung von ETL- und ELT-Prozessen, mehr als 90 integrierten Konnektoren und Unterstützung für SSIS-Migrationen.
ADF glänzt, wenn es um Orchestrierung, Copy-Aktivitäten, Hybrid-Szenarien, Low-Code-Entwicklung und Integration vieler Systeme geht. Für viele Unternehmen ist ADF der pragmatische Einstieg in Cloud-Datenintegration. Man kann relativ schnell Pipelines bauen, Daten verschieben und Prozesse überwachen.
Databricks spielt seine Stärke dagegen aus, wenn Transformationen anspruchsvoll werden. Große Datenmengen, komplexe Logik, PySpark, SQL, Streaming, Delta Lake, Datenqualitätsregeln, CI/CD-orientierte Entwicklung und AI-nahe Workloads sind typische Databricks-Domänen. Die schöne Faustregel wäre:
Azure Data Factory ist oft der bessere Pipeline-Dirigent. Databricks ist oft der stärkere Transformationsmotor.
In der Praxis werden beide daher häufig kombiniert. ADF orchestriert darüberliegende Datenflüsse, Databricks verarbeitet die schweren Transformationen. Das ist nicht unromantisch, sondern Architekturalltag. Nicht jedes Tool muss alles tun, auch wenn Marketingfolien das manchmal behaupten.
Vergleich mit AWS Glue: Serverless-Komfort gegen Plattformbreite
AWS Glue ist naheliegend, wenn ein Unternehmen stark in AWS unterwegs ist. Der Dienst bietet serverlose Datenintegration, einen zentralen Data Catalog, visuelle Pipeline-Erstellung, Spark-basierte ETL-Jobs, automatische Skalierung und Integration in AWS-Analytics-Dienste. AWS hebt außerdem die Fähigkeit hervor, Daten aus über 100 Quellen zu entdecken, vorzubereiten und zu integrieren.
Für AWS-zentrierte Architekturen ist Glue häufig eine sehr gute Wahl. Es reduziert Infrastrukturaufwand, integriert sich eng in S3, Redshift, Athena und andere AWS-Dienste und bietet einen klaren Pay-as-you-go-Ansatz.
Databricks ist im Vergleich besonders interessant, wenn Unternehmen cloudübergreifend denken, offene Lakehouse-Architekturen verfolgen oder eine einheitliche Plattform für Data Engineering, Analytics und AI suchen. Databricks positioniert sich mit Lakeflow, Unity Catalog und der Data Intelligence Platform explizit breiter als reine ETL-Ausführung.
Das bedeutet nicht, dass Databricks immer „besser“ ist. In reinen AWS-Standardarchitekturen kann Glue einfacher, günstiger und organisatorisch passender sein. Aber bei komplexen Datenprodukten, Multi-Cloud-Strategien oder AI-nahen Plattformen gewinnt Databricks an Gewicht.
Vergleich mit Google Cloud Dataflow: Beam gegen Lakehouse
Google Cloud Dataflow ist besonders stark in Streaming- und Batch-Verarbeitung auf Basis von Apache Beam. Google beschreibt Dataflow als vollständig verwalteten Dienst für skalierbare Pipelines, der Daten aus Quellen liest, transformiert und in Ziele wie BigQuery schreibt. Typische Use Cases sind ETL, Datenbewegung, BI-Dashboards, Echtzeit-ML, Sensor- und Logdatenverarbeitung.
Ein großer Vorteil von Dataflow ist das Apache-Beam-Modell. Beam bietet Portabilität, weil Pipelines theoretisch auch auf anderen Runnern ausgeführt werden können. Für Unternehmen mit starkem Google-Cloud-Fokus und anspruchsvollen Streaming-Szenarien ist Dataflow daher sehr attraktiv.
Databricks ist dagegen stärker als integrierte Lakehouse-Plattform. Es geht nicht nur um die Ausführung von Datenverarbeitung, sondern um das Zusammenspiel aus Speicherformaten, Transformationen, Governance, SQL, Notebooks, Jobs, Lineage und AI/ML. Lakeflow und Unity Catalog sind hier zentrale Bausteine.
Man könnte zuspitzen: Dataflow ist eine sehr gute Engine für Datenflusslogik. Databricks ist eine Plattform, auf der Datenflüsse Teil eines größeren Data-Engineering- und AI-Betriebsmodells werden.
Vergleich mit Snowflake: SQL-Eleganz gegen Engineering-Flexibilität
Snowflake hat sich längst vom reinen Cloud Data Warehouse zu einer umfassenden Datenplattform entwickelt. Mit Dynamic Tables, Streams und Tasks bietet Snowflake starke Möglichkeiten für deklarative und prozedurale Datenpipelines. Dynamic Tables materialisieren SELECT-Abfragen und halten Ergebnisse abhängig von einem definierten Target Lag aktuell. Snowflake empfiehlt sie besonders für deklarative SQL-Pipelines mit Joins, Aggregationen oder mehrstufigen Bronze/Silver/Gold-Mustern.
Für SQL-zentrierte Analytics-Teams ist das großartig. Wenn Datenmodelle hauptsächlich in SQL entstehen und das Ziel ein performantes Warehouse ist, können Snowflake Dynamic Tables oder dbt-basierte Ansätze sehr elegant sein.
Databricks ist stärker, wenn SQL nicht ausreicht. Sobald PySpark, strukturierte und unstrukturierte Daten, ML-Feature-Berechnung, Streaming, komplexe Dateiformate oder Notebook-basierte Exploration ins Spiel kommen, bietet Databricks mehr Engineering-Flexibilität. Das ist besonders relevant, wenn Daten nicht nur für Reporting, sondern auch für ML-Modelle, GenAI-Anwendungen oder operative Datenprodukte vorbereitet werden sollen.
Snowflake ist oft die bequemere SQL-Autobahn. Databricks ist eher der Allradwagen fürs Gelände. Beides kann schnell sein, aber nicht auf demselben Terrain.
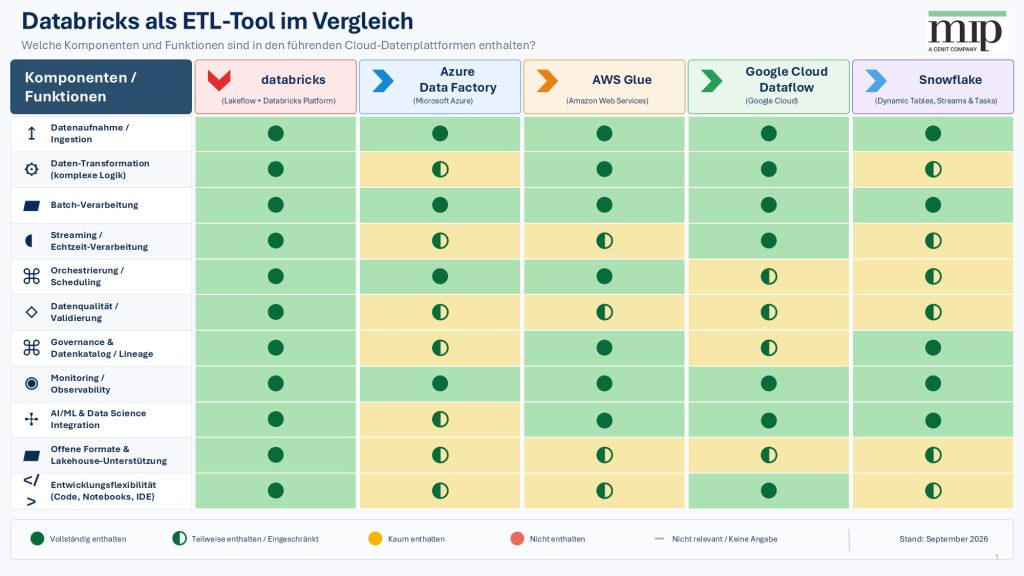
Auf einen Blick
Die unterschätzte Stärke: ETL als Vorbereitung für AI
Der vielleicht wichtigste Punkt: ETL ist heute nicht mehr nur Vorbereitung für Reporting. ETL ist Vorbereitung für AI.
Machine-Learning-Modelle, Feature Stores, Retrieval-Augmented Generation, semantische Suche, Recommender-Systeme oder operative AI-Anwendungen benötigen saubere, aktuelle, nachvollziehbare und gut kuratierte Daten. Genau hier wird die klassische Trennung zwischen ETL, Data Engineering, Data Science und AI zunehmend künstlich.
Databricks adressiert diese Verbindung deutlich. Lakeflow Connect wird unter anderem für Use Cases wie Customer 360, Forecasting, Digital Twins und RAG-Chatbots beschrieben. Google Dataflow betont ebenfalls Echtzeit-ML- und Streaming-AI-Szenarien. Der Markt bewegt sich also klar in Richtung Datenplattformen, die nicht nur BI-Dashboards befüllen, sondern intelligente Anwendungen ermöglichen.
Hier liegt der strategische Wert von Databricks: ETL ist kein isolierter Kellerjob mehr, bei dem nachts Datenpakete verschoben werden, während alle schlafen. ETL wird zum Produktionsprozess für datengetriebene Geschäftslogik. Und wenn AI eine Fabrik ist, dann sind Datenpipelines das Fließband. Ein wackeliges Fließband produziert keine intelligenten Ergebnisse, sondern sehr selbstbewusst klingenden Unsinn.
Risiken: Wo Databricks nicht glänzt
Natürlich wäre ein Blogbeitrag unseriös, wenn er Databricks nur als Wundermittel beschreibt. Databricks ist mächtig, aber Macht kommt bekanntlich mit Verantwortung und gelegentlich mit einer überraschend hohen Cloud-Rechnung.
1. Komplexität
Databricks braucht Know-how. Teams müssen Spark, SQL, Python, Delta Lake, Cluster- beziehungsweise Serverless-Konzepte, Job-Orchestrierung, Berechtigungen, Performance-Tuning und Kostenmodelle verstehen. Azure Data Factory kann für einfachere Szenarien deutlich zugänglicher sein, weil es stärker visuell beziehungsweise managed arbeitet.
2. Kostenkontrolle
Databricks kann sehr effizient sein, aber nur bei sauberer Architektur. Unoptimierte Spark-Jobs, falsch dimensionierte Cluster, unnötiges Reprocessing, schlechte Partitionierung oder fehlendes Monitoring können teuer werden. Dieses Risiko betrifft allerdings nicht nur Databricks: Auch AWS Glue, Dataflow und andere nutzungsbasierte Cloud-Dienste erfordern Kostenbewusstsein und Betriebsdisziplin.
3. Governance ist kein Selbstläufer
Unity Catalog, Lineage und zentrale Governance-Funktionen sind starke Bausteine. Aber sie ersetzen keine organisatorische Data-Governance-Strategie. Ownership, Namenskonventionen, Datenqualitätsregeln, Zugriffskonzepte, CI/CD, Teststrategien und Betriebsprozesse müssen bewusst definiert werden. Databricks stellt Fähigkeiten bereit, aber keine Unternehmenskultur per Knopfdruck.
4. Vendor Lock-in
Databricks arbeitet mit offenen Formaten und Lakehouse-Prinzipien, dennoch entstehen in der Praxis Abhängigkeiten: Jobs, Workflows, Unity Catalog, Lakeflow-Konzepte, Notebooks, Plattformkonfigurationen und APIs. Ähnliche Abhängigkeiten gibt es bei Snowflake Dynamic Tables, AWS Glue, Azure Data Factory oder Google Dataflow ebenfalls. Der entscheidende Punkt ist nicht, Lock-in vollständig zu vermeiden — das ist oft illusorisch — sondern ihn bewusst zu managen.
5. Nicht jedes Problem braucht Databricks
Wer nur einige SaaS-Datenquellen in ein Warehouse replizieren und einfache Reporting-Modelle bauen möchte, fährt mit anderen Tools möglicherweise schneller. Wer hauptsächlich Azure Copy-Jobs orchestriert, ist mit Azure Data Factory oft pragmatischer unterwegs. Wer rein SQL-zentrierte Warehouse-Pipelines baut, kann mit Snowflake Dynamic Tables sehr elegant arbeiten.
Databricks ist kein Hammer für jede Schraube. Und wer Schrauben hämmert, darf sich über das Ergebnis nicht wundern.
Wann Databricks besonders sinnvoll ist
Databricks ist besonders stark, wenn mehrere der folgenden Bedingungen erfüllt sind:
- Es gibt große oder schnell wachsende Datenmengen.
- Transformationen sind komplexer als einfache Mappings.
- Batch und Streaming sollen nicht getrennt betrieben werden.
- Daten sollen für Analytics und AI genutzt werden.
- Offene Lakehouse-Architekturen sind strategisch wichtig.
- Data Engineering, Data Science und BI sollen enger zusammenarbeiten.
- Governance, Lineage und Qualität müssen zentral gedacht werden.
- Es gibt Bedarf an programmatischer Flexibilität mit SQL, Python und Spark.
- Datenprodukte sollen produktionsnah betrieben werden, nicht nur als BI-Extrakte.
Das sind genau die Szenarien, in denen klassische ETL-Werkzeuge oft unbequem werden. Sie können die Aufgabe vielleicht lösen, aber häufig nur mit zusätzlicher Komplexität, Workarounds oder einer Toolchain, die irgendwann mehr Pflege braucht als der eigentliche Datenprozess.
Anti-These: Databricks ist als ETL-Tool überschätzt
Eine faire Betrachtung braucht auch die Gegenposition. Man könnte sagen: Databricks ist als ETL-Tool überschätzt, wenn es für einfache Integrationsaufgaben eingesetzt wird. Wenn ein Unternehmen nur Quellsysteme verbinden, Daten kopieren und einfache Transformationen ausführen möchte, ist Databricks oft zu schwergewichtig. Dann wirken Cluster, Spark, Notebooks und Lakehouse-Konzepte schnell wie ein Formel-1-Wagen für den Weg zum Bäcker.
Diese Anti-These ist berechtigt.
Aber sie trifft nicht den Kern. Databricks sollte nicht daran gemessen werden, ob es das bequemste Werkzeug für einfache ETL-Jobs ist. Es sollte daran gemessen werden, ob es moderne, skalierbare und AI-fähige Datenplattformen ermöglicht. Und in diesem Kontext ist Databricks kein überdimensioniertes ETL-Tool, sondern ein strategischer Data-Engineering-Baustein.
Die Frage lautet also nicht: „Ist Databricks besser als Azure Data Factory, Glue, Dataflow oder Snowflake?“ Die bessere Frage lautet:
Für welches Datenbetriebsmodell bauen wir eigentlich?
Wenn das Ziel nur Datenbewegung ist, gibt es einfachere Werkzeuge. Wenn das Ziel aber eine robuste Plattform für Analytics, AI, Streaming, Governance und Datenprodukte ist, dann wird Databricks hochrelevant.
Fazit: Databricks wird unterschätzt, weil ETL unterschätzt wird
Databricks wird als ETL-Tool unterschätzt, weil ETL selbst häufig unterschätzt wird. Viele Unternehmen betrachten ETL noch immer als technische Hintergrundaufgabe: Daten rein, Daten raus, Dashboard grün. Doch in modernen Cloud-Architekturen ist ETL der Maschinenraum der Datenwertschöpfung.
Hier werden Rohdaten zu vertrauenswürdigen Datenprodukten. Hier entscheidet sich, ob AI-Anwendungen brauchbare Informationen erhalten oder nur hübsch formulierten Datennebel produzieren. Hier entstehen Qualität, Nachvollziehbarkeit, Performance, Kostenstruktur und Governance.
Databricks ist nicht immer die einfachste Antwort. Es verlangt technisches Verständnis, Architekturdisziplin und Betriebsreife. Aber genau deshalb ist es so leistungsfähig. Es ist weniger ein klassisches ETL-Tool als eine Plattform, auf der ETL, ELT, Streaming, Data Engineering, Analytics und AI zusammenwachsen.
Die Schlussformel könnte lauten:
Databricks wird als ETL-Tool unterschätzt, weil es nicht wie ein ETL-Tool aussieht. Seine Stärke liegt nicht darin, alte ETL-Muster hübscher nachzubauen, sondern darin, ETL als Kern moderner Cloud-Datenplattformen neu zu definieren.
Und vielleicht ist das die eigentliche Pointe: Wer Databricks nur als Spark-Plattform sieht, unterschätzt es. Wer es nur als AI-Plattform sieht, ebenfalls. Wer es aber als industriellen Datenverarbeitungsmotor im Lakehouse versteht, erkennt, warum es im ETL-Kontext viel mehr Aufmerksamkeit verdient.
Databricks bei der mip
Mit unserer langjährigen Erfahrung in Data Warehousing, Datenintegration, Analytics und KI bringen wir genau das Know-how mit, das für erfolgreiche Databricks-Projekte erforderlich ist. Wir unterstützen Kunden von der Entwicklung der Datenstrategie und Zielarchitektur über Evaluierung und Proof of Concept bis zur Implementierung und Betreuung im laufenden Betrieb. Dabei verbinden wir tiefgreifendes technisches Verständnis mit pragmatischer Umsetzung und richten die Plattform konsequent an den fachlichen Anforderungen des Unternehmens aus. So entstehen im Databricks-Umfeld keine technologischen Insellösungen, sondern skalierbare Datenplattformen, die Analytics, Data Engineering und KI langfristig zusammenführen.

Ob Datenstrategie, Proof of Concept oder produktiver Betrieb: Wir begleiten Sie auf dem gesamten Weg zu einer zukunftssicheren Data-Plattform. Profitieren Sie von unserer Erfahrung in Data Warehousing, Analytics und KI und lassen Sie uns gemeinsam Ihre Anforderungen besprechen. Dafür stehe ich Ihnen sehr gerne zur Verfügung.
Ihr Uli Drexelius
Principal Consultant
Wenn Sie daran interessiert sind, Daten nahtlos zu integrieren und eine skalierbare Grundlage für Analytics, Data Engineering und KI zu schaffen, erfahren Sie hier mehr über unsere Lösungen zur Datenintegration.